EduData
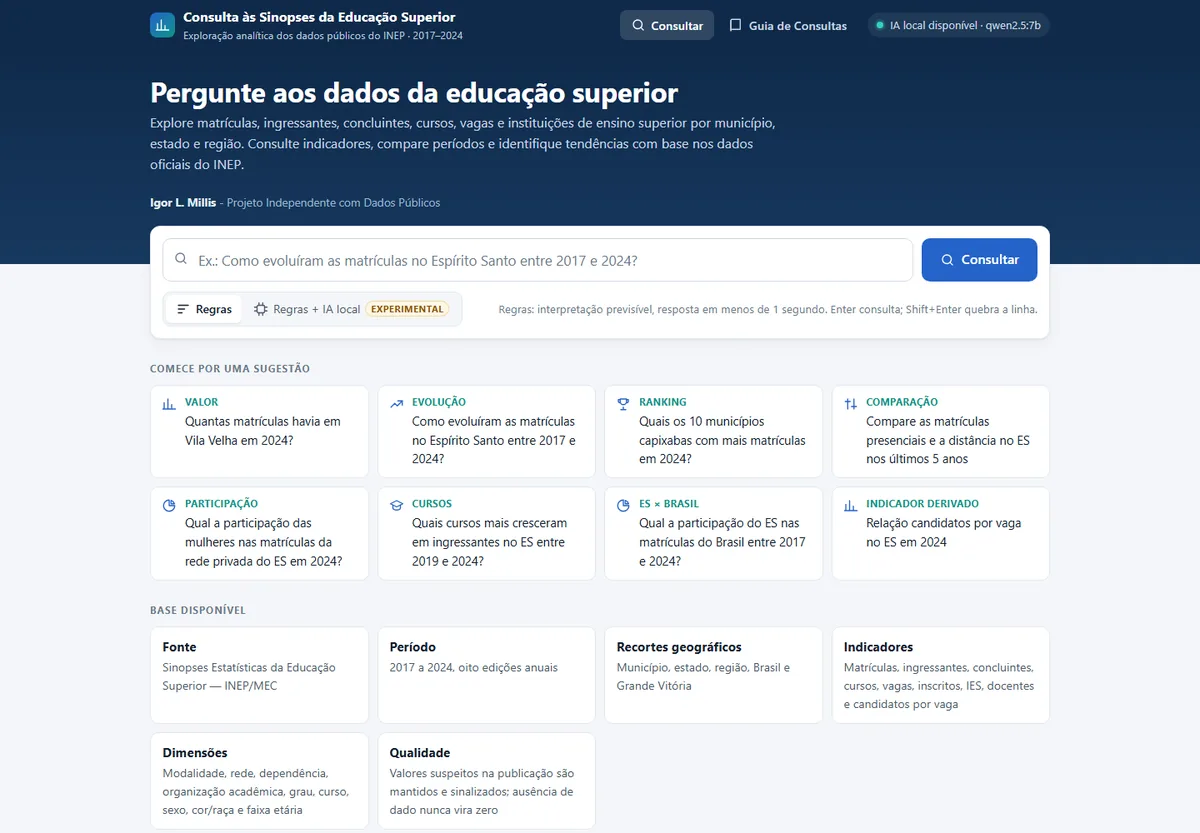
Pergunte em português sobre oito edições das estatísticas da educação superior brasileira. Os números vêm do banco — nunca de um modelo.
Testar a versão online ↗ plano gratuito: a primeira visita pode levar ~1 min para acordar o servidor
- fonte
- INEP/MEC — Sinopses Estatísticas da Educação Superior
- período
- 2017–2024 (8 edições anuais)
- armazenamento
- DuckDB (~4,5 GB) · staging em Parquet
- execução
- local (Python 3.12 · Windows) ou online (Render · só regras · banco enxuto de 105 MB)
- llm
- Ollama + Qwen2.5 7B (opcional)
- status
- v1 entregue · projeto independente
- versão online
- consulta-sinopses.onrender.com ↗
Dado público, formato hostil
As Sinopses do INEP são as estatísticas oficiais anuais da educação superior brasileira — mas chegam como centenas de abas de planilha por ano, com layouts que mudam entre edições. Responder “como evoluíram as matrículas no Espírito Santo?” exige abrir pastas de trabalho, achar a aba certa e torcer para as colunas significarem o mesmo que no ano anterior.
Objetivo: uma ferramenta em que qualquer pessoa pergunta em português e recebe um número calculado, rastreável e honesto sobre o que a base não contém.
Sete camadas do ZIP à resposta
Os arquivos originais nunca são alterados. Cada valor do núcleo guarda a aba e a célula da planilha do INEP de onde veio. Selecione uma etapa:
Pergunta → consulta → SQL
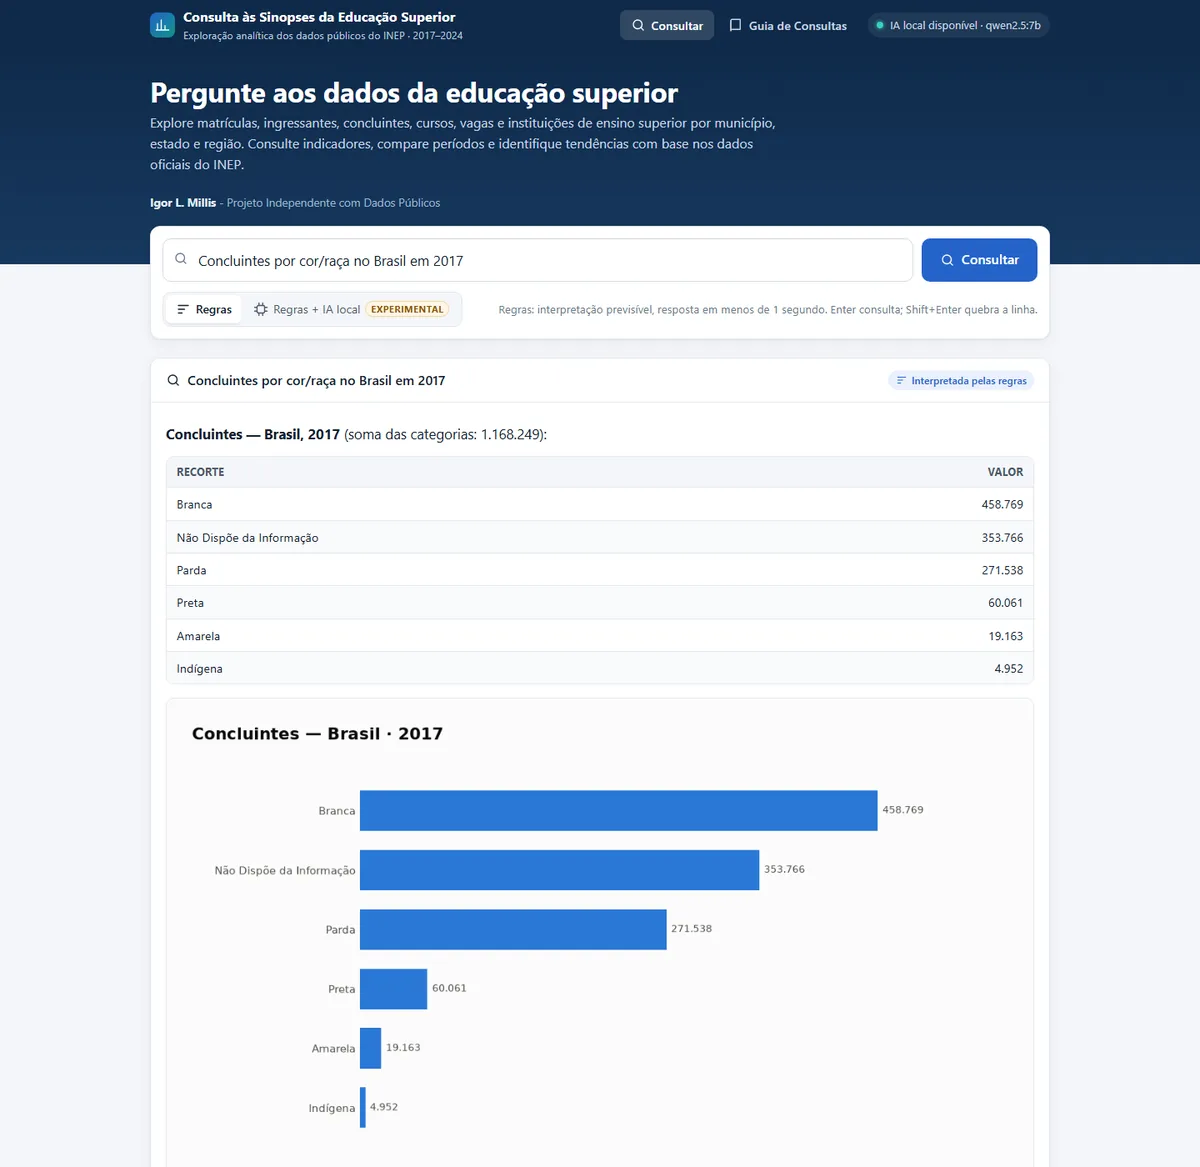
Um interpretador por regras, com catálogo semântico, transforma a pergunta numa Consulta estruturada. Essa consulta em JSON é validada contra o catálogo e o banco e então compilada em SQL parametrizado, executado numa conexão somente leitura. Rankings, crescimento e participações são calculados depois, em Python.
Reproduza perguntas reais do gabarito do projeto:
Consultas retiradas de tests/gold_interpretacoes.jsonl. SQL reproduzido a partir do planejador em motor/consultas.py — um replay, não um banco ao vivo.
Onde um LLM local ajuda — e onde não
Um modelo local (Ollama, em CPU) pode ajudar a interpretar perguntas que as regras não reconhecem. Ele segue o mesma estrutura de consulta em JSON: devolve nomes, nunca SQL nem números. A decisão de mantê-lo opcional veio de medi-lo em 40 perguntas parafraseadas e inéditas:
| interpretador | paráfrases /24 | controle inédito /16 | total /40 | tempo médio |
|---|---|---|---|---|
| Regras | 24* | 14 | 38* | 0,2 s |
| LLM 3B sozinho | 13 | 8 | 21 | 11 s |
| LLM 7B sozinho | 14 | 13 | 27 | 21–23 s |
| Híbrido (regras + 7B) | 24* | 14 | 38* | 0,5–1 s |
* As regras foram ajustadas depois de ver as falhas nas paráfrases, então 24/24 não mede generalização; o conjunto de controle inédito mede. Fonte: _arquitetura/02_decisoes.md (D17).
Decisão: regras por padrão; modo híbrido com o modelo 7B como opção, com aviso obrigatório para conferir a interpretação. Nenhum modelo sozinho igualou as regras — o 7B errou muito menos que o 3B (27 × 21 de 40), então, quando o modelo é usado, a exatidão pesa mais que a latência.
Regras de honestidade, garantidas em código
- Nada é corrigido em silêncio. Inconsistências da publicação (ocorrências Q01–Q13) ficam como publicadas, recebem status
suspeitoe são citadas nas respostas. - Ausência ≠ zero. Linhas ausentes nunca viram zero; participações sem numerador ficam indefinidas.
- Razões são razões de somas — nunca médias de razões.
- Segurança do SQL em camadas: conexão somente leitura, só SELECT/WITH, lista de tabelas autorizadas, sem acesso a arquivos, limite de 60 s e de 5.000 linhas, toda consulta registrada.
- Operações reversíveis: compactação do banco por cópia-validação-troca (5,11 → 4,48 GB), com equivalência provada nas 61 respostas do gabarito.
Gráficos que afirmam a conclusão
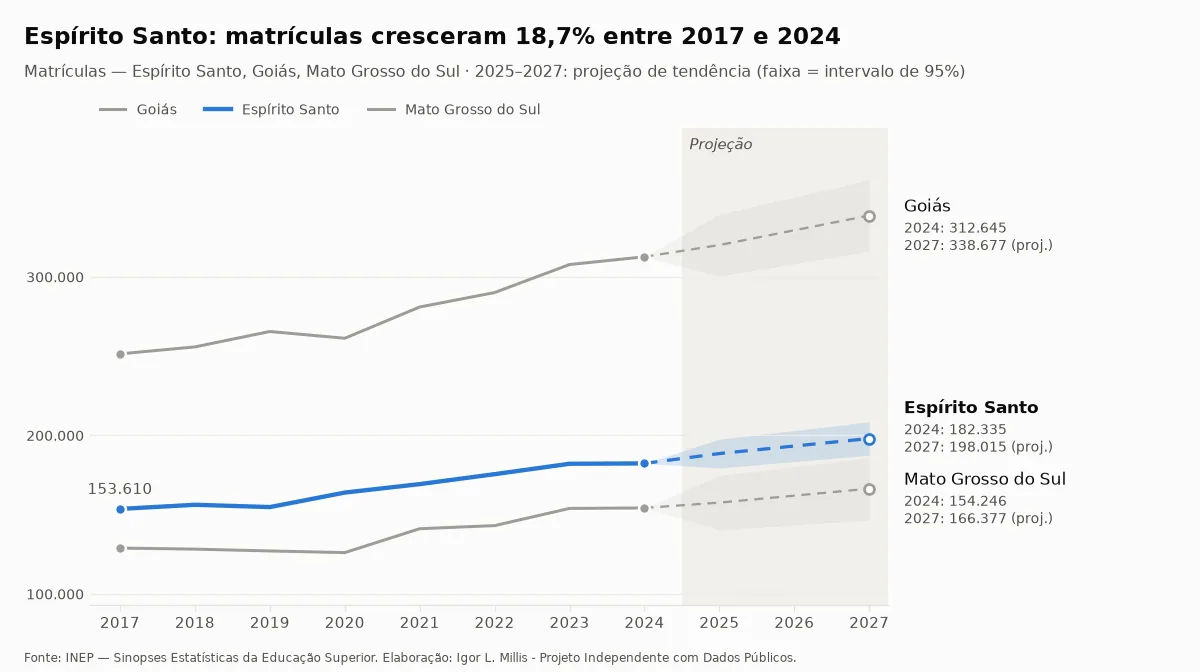
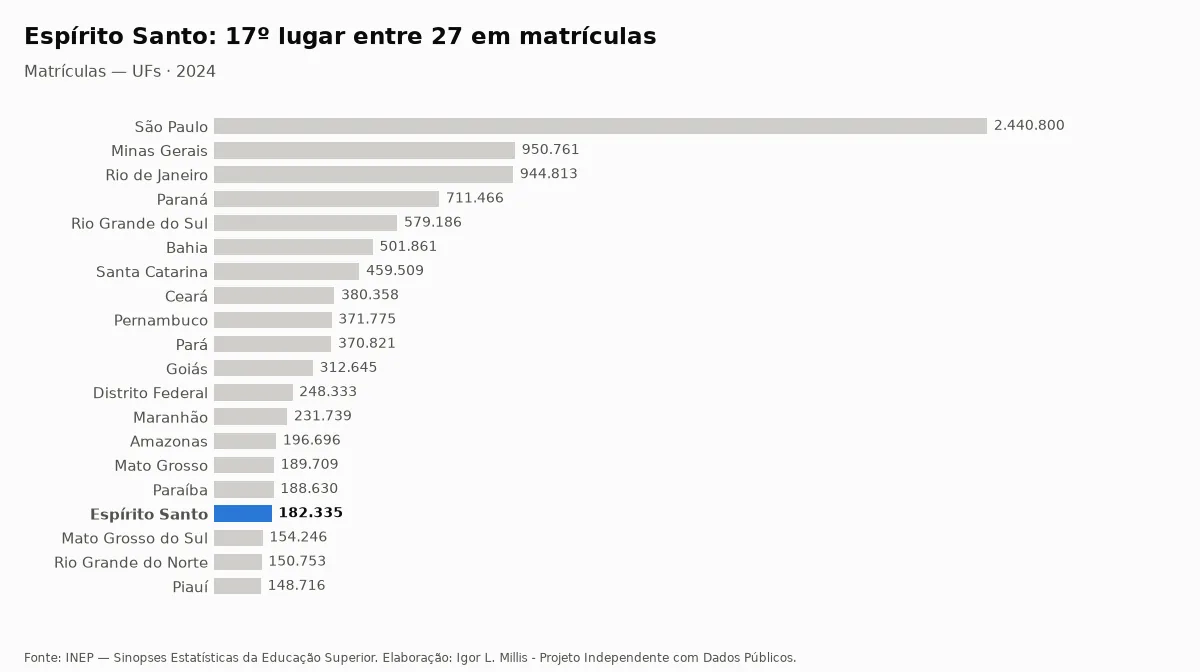
O título afirma o achado, só o Espírito Santo recebe cor, os valores são rotulados na ponta da linha e as séries anuais ganham uma projeção de 3 anos por tendência linear com intervalo de previsão de 95% — marcada como extrapolação estatística, não dado do INEP.
Limitações conhecidas
- Deficiência, cotas, financiamento, turno, nacionalidade e titulação docente existem na base, mas ainda não estão disponíveis no motor.
- As Sinopses não publicam taxas de evasão ou conclusão por coorte; cursos, vagas e inscritos a distância só existem no total Brasil.
- O interpretador por regras cobre as formas de pergunta documentadas no guia; o LLM local é experimental (27/40 sozinho).
- O banco (~4,5 GB) não está no repositório — é reconstruído a partir dos ZIPs públicos (~3 h) com o manifesto de MD5.
Projeto independente com dados públicos — não é produto oficial de nenhuma instituição.