Adaptive Recommender
Um fim de semana brincando com sistemas de recomendação: cinco modelos diferentes, um motor que decide quanto ouvir cada um para cada cliente e uma avaliação que não esconde quando a ideia sofisticada só empata com a simples.
- motivação
- projeto de fim de semana · aprender e se divertir
- dados
- 300 lojas sintéticas + Online Retail II (UCI, dados reais)
- tarefa
- sugerir produtos que a loja ainda não comprou (próximos 92 dias)
- modelos
- conteúdo · colaborativo · supervisionado · bayesiano · popularidade
- avaliação
- validação temporal · IC por bootstrap · comparações pareadas
- interface
- app Streamlit com 5 páginas · roda 100% local
Que produto sugerir para cada loja?
Imagine uma distribuidora de roupas que vende no atacado para lojas: camisetas, calças, vestidos, roupas esportivas, acessórios. Cada loja é um cliente com gosto próprio — uma vende moda esportiva, outra só compra o que é barato, outra concentra as compras no verão. O vendedor da distribuidora quer abrir o sistema e ver, para cada loja, uma lista curta de produtos que ela ainda não comprou e que provavelmente compraria.
Isso é um sistema de recomendação: um programa que ordena os produtos do mais para o menos provável de interessar a um cliente e mostra os primeiros (aqui, os 10 primeiros). Repare em dois detalhes que mudam tudo:
- Só produtos novos para a loja. Recomendar o que ela já compra toda semana é fácil e inútil. A tarefa é de descoberta.
- Não existe um único jeito certo de adivinhar. Dá para olhar o que a loja já comprou, o que lojas parecidas compram, o que está vendendo bem, como ela reagiu a sugestões anteriores… Cada caminho acerta em situações diferentes.
A pergunta que me motivou foi: e se, em vez de escolher um método, eu usasse vários e deixasse o sistema decidir quanto confiar em cada um, cliente por cliente? Isso se chama mixture of experts (mistura de especialistas). O resto da página mostra como construí isso, um passo de cada vez, e o que aconteceu quando testei de verdade.
Nove etapas, do dado bruto à recomendação
Antes dos detalhes, o mapa. O sistema é uma sequência de etapas; cada uma recebe o resultado da anterior. Clique em cada etapa para ver o que ela faz e por quê:
Criar os dados. Não havia dados reais de uma distribuidora, então escrevi um gerador de dados sintéticos: 300 lojas, 200 produtos, cerca de 59 mil itens de pedido e 99 mil interações com recomendações ao longo de dois anos. Os dados não são aleatórios — cada loja tem um "gosto escondido" e as compras seguem esse gosto (detalhes na seção 03).
Depois, para conferir que eu não estava apenas reencontrando os padrões que eu mesmo inventei, rodei tudo também sobre dados reais públicos (seção 08).
Guardar com organização. Tudo vai para um banco SQLite com 19 tabelas: clientes, produtos, pedidos, itens, interações, versões de modelos, estimativas bayesianas, recomendações exibidas, pesos usados e resultados de avaliação.
O banco tem regras de integridade (por exemplo, não existe pedido de um cliente inexistente, estoque nunca fica negativo, um peso precisa estar entre 0 e 1). Isso impede que um erro de código corrompa os dados em silêncio.
Respeitar o tempo. Este é o cuidado mais importante do projeto. Um modelo só pode usar o que se sabia no dia em que a recomendação seria feita. Se eu treinar com compras de outubro para "prever" setembro, o resultado fica lindo e é mentira — isso se chama vazamento de informação.
Por isso todo o código trabalha com fotografias no tempo (snapshots): "os dados como estavam em 1º de agosto". Se algum registro posterior aparecer num snapshot, o programa para com erro.
Transformar histórico em números. Modelos não leem pedidos; leem números. Para cada loja calculo características como número de pedidos, ticket médio, frequência, dias desde a última compra e participação de cada categoria nas compras.
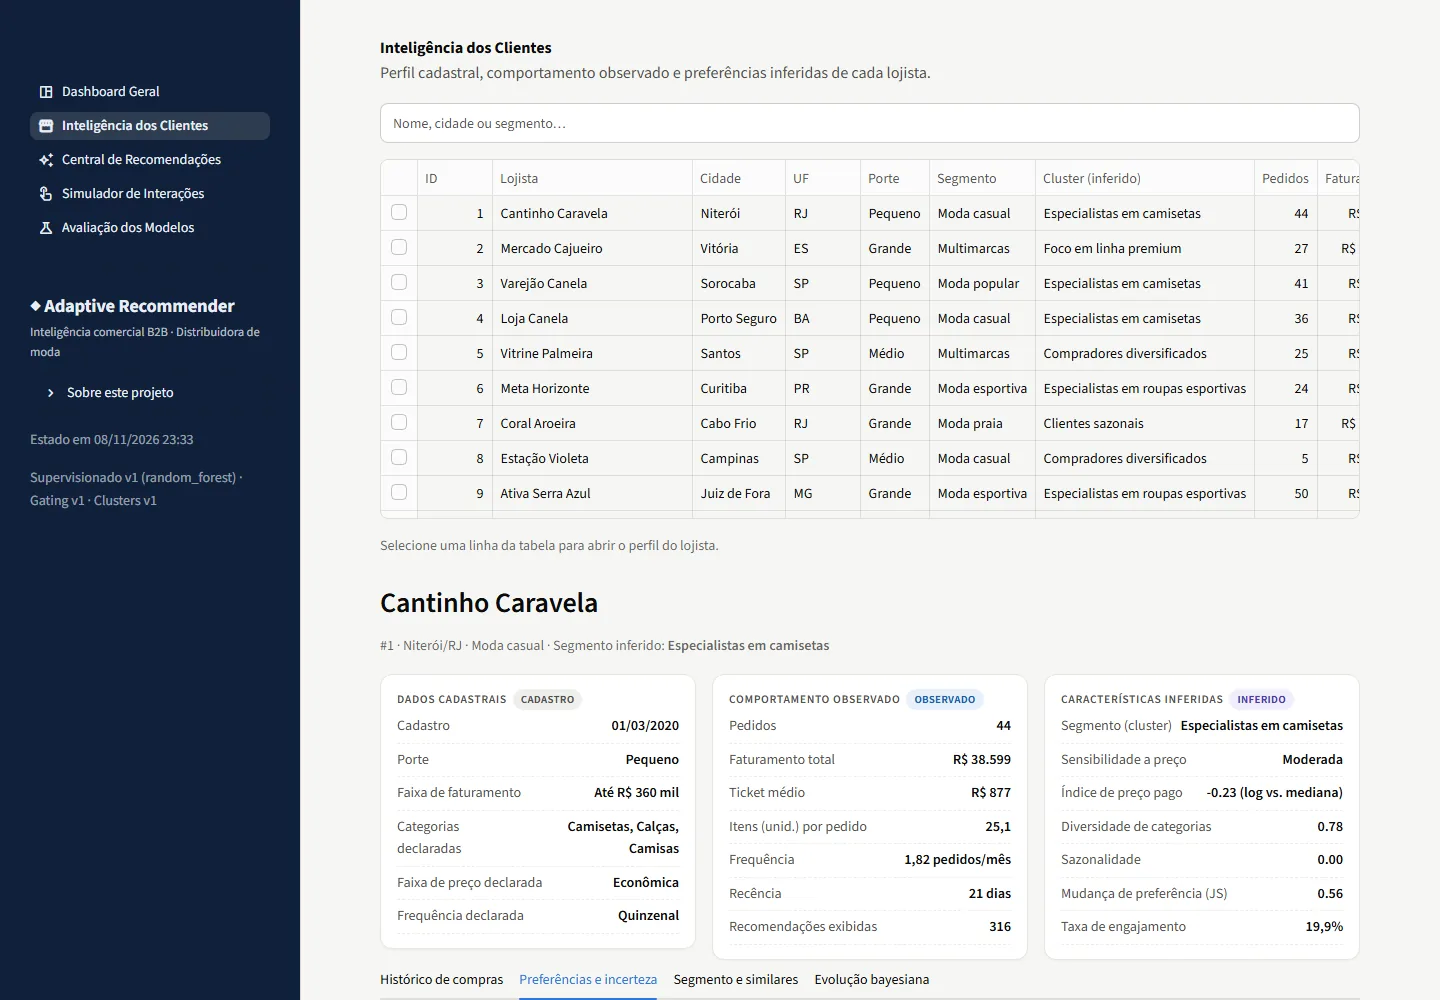
Separo dois tipos: observado (contado diretamente, como "fez 44 pedidos") e inferido (depende de uma hipótese, como "é sensível a preço" ou "mudou de gosto recentemente"). Na interface, cada número carrega um selo dizendo de qual tipo ele é.
Cinco formas de adivinhar. Cinco modelos diferentes dão, cada um, uma nota para cada par loja × produto: conteúdo, colaborativo, supervisionado, bayesiano e popularidade (seção 04 explica cada um com calma).
Todos seguem a mesma "tomada": recebem os dados até uma data, devolvem uma tabela de notas, dizem quanta confiança têm em cada loja e sabem explicar uma nota. Graças a isso, dá para trocar ou acrescentar um modelo sem mexer no resto.
Decidir quanto ouvir cada um. As notas dos cinco especialistas vêm em escalas diferentes, então primeiro elas são colocadas numa régua comum de 0 a 1. Depois o motor adaptativo escolhe pesos que somam 100% — diferentes para cada loja — e faz uma média ponderada.
Uma loja nova, sem histórico, recebe muito peso de "popularidade"; uma loja antiga e consistente recebe mais peso de "conteúdo" e "colaborativo" (seção 05).
Montar a lista final. Antes de ordenar, removo o que não pode ser sugerido: produtos sem estoque, ainda não lançados, já comprados ou rejeitados recentemente pela loja. Depois ordeno, opcionalmente diversifico (para não sugerir dez camisetas quase iguais) e escrevo o motivo de cada sugestão.
A margem de lucro existe como um objetivo separado e opcional: relevância para o cliente e rentabilidade para a empresa nunca são misturadas sem você pedir.
Aprender com cada reação. Quando a loja clica, demonstra interesse, coloca no carrinho, compra ou rejeita uma sugestão, o evento é gravado e o sistema atualiza imediatamente o que acredita sobre aquela loja — sem precisar retreinar tudo.
Cada tipo de reação pesa diferente: comprar diz muito mais que clicar, e simplesmente ver uma sugestão sem reagir diz quase nada (seção 06).
Testar no futuro. Os modelos são treinados com dados até abril/2026, ajustados com maio–julho e testados em agosto–outubro, período que nenhum deles viu. Medimos se os produtos sugeridos foram mesmo comprados.
Todo resultado vem com intervalo de confiança: com algumas centenas de lojas, uma diferença pequena entre dois métodos pode ser só sorte (seção 07).
Um mundo de mentira com regras de verdade
Dados inventados só servem para testar um modelo se tiverem estrutura: padrões que um bom método consiga encontrar e um método ruim não. Por isso o gerador não sorteia compras ao acaso. Ele funciona assim:
1. Cada loja ganha um tipo escondido (um arquétipo): especialista em moda esportiva, sensível a preço, moda social, sazonal (compra muito no verão), diversificada, de alto ticket, "migrante" (muda de gosto aos poucos ao longo do tempo) e "complementar" (compra calça junto com camisa, vestido junto com acessório). O tipo define o gosto por categoria, por estilo e o quanto o preço pesa.
2. Cada produto tem uma "utilidade" para cada loja — um número que diz o quanto ela gosta daquele produto naquele mês. De forma simplificada:
3. Os pedidos acontecem no tempo. Todo mês cada loja faz um número aleatório de pedidos (uma distribuição de Poisson, com mais pedidos na "sua" estação) e escolhe produtos sorteando com probabilidade maior para utilidade maior.
4. Existe um recomendador antigo mostrando 6 produtos antes de cada pedido. A loja reage num funil: às vezes clica, às vezes coloca no carrinho, às vezes compra, às vezes rejeita — e, na maioria das vezes, simplesmente ignora. Essas reações viram a tabela de interações.
5. Clientes novos de propósito. Algumas lojas se cadastram só no fim do período — algumas nem compram nada. Isso cria o problema do cold start: como recomendar para quem não tem histórico?
O ponto crucial: o tipo escondido de cada loja fica num arquivo separado que nenhum modelo lê. Os modelos precisam descobrir os padrões a partir das compras, como fariam no mundo real.
Seis formas de olhar para o mesmo cliente
Cada método responde a uma pergunta diferente sobre a loja. Para cada um: a intuição, como funciona, a fórmula principal e onde ele brilha ou falha. Clique para alternar:
a intuição
"Na dúvida, sugira o que está vendendo bem." É o método mais simples e serve de linha de base: qualquer método sofisticado precisa vencê-lo.
como funciona
Para cada produto conto quantas lojas diferentes o compraram nos últimos 180 dias, dando mais peso às compras recentes (o peso cai pela metade a cada 60 dias). A lista é a mesma para todas as lojas.
onde brilha e onde falha
É ótimo para lojas novas, sobre as quais não sabemos nada. Para todas as outras é fraco: ignora completamente o gosto de cada uma.
a intuição
"Se a loja compra leggings e tops de academia, sugira outros produtos parecidos com esses." O método olha para as características dos produtos.
como funciona
Passo 1 — transformar cada produto num vetor de números. Atributos como categoria, subcategoria, público, faixa de preço, material, cor e estação viram colunas 0/1 (one-hot). O texto da descrição vira números com TF-IDF, que dá peso alto a palavras raras e informativas ("academia", "corporativo") e peso baixo a palavras comuns.
Passo 2 — medir semelhança com o cosseno, que olha o ângulo entre dois vetores: 1 = apontam para o mesmo lado (muito parecidos), 0 = nada em comum.
Passo 3 — criar o perfil da loja: a soma dos vetores dos produtos que ela comprou, com mais peso para compras recentes e maiores. Interesses e cliques somam um pouco; rejeições subtraem. Se a loja mudou de gosto recentemente, o "esquecimento" fica mais rápido (meia-vida de 60 em vez de 180 dias). A nota de um produto é o cosseno entre ele e o perfil.
onde brilha e onde falha
Funciona bem com histórico consistente e é o único método que recomenda produtos recém-lançados (que ninguém comprou ainda). Mas nunca surpreende: só sugere mais do mesmo. Uma vantagem: a explicação é exata — dá para dizer "42% da nota veio da categoria, 18% da faixa de preço".
a intuição
"Lojas que compram parecido com você também compraram isto." Não olha para o produto em si, só para quem comprou o quê.
como funciona
Passo 1 — a matriz loja × produto. Uma tabela com uma linha por loja e uma coluna por produto; cada célula diz o quanto a loja comprou aquele produto (com peso maior para compras recentes). A maioria das células é zero.
Passo 2 — achar os vizinhos. Duas lojas são parecidas se suas linhas apontam para o mesmo lado (cosseno). Como lojas com poucos produtos em comum podem parecer parecidas por acaso, a similaridade é "encolhida" quando há pouca sobreposição:
Passo 3 — votação dos vizinhos. Pego as 10 lojas mais parecidas; a nota de um produto é a média do quanto elas o compraram, ponderada pela semelhança.
Variante testada: fatoração de matrizes (ALS). Em vez de vizinhos, resume cada loja e cada produto em 12 "fatores escondidos" cujo produto reconstrói a matriz. Funciona bem em matrizes gigantes e esparsas; aqui perdeu para os vizinhos (0,207 × 0,270), por isso ficou só como comparação.
onde brilha e onde falha
Descobre padrões que nenhuma característica de produto revela. Mas não funciona para lojas sem histórico (não há com quem compará-las) nem para produtos que ninguém comprou.
a intuição
Transformar a recomendação numa pergunta de sim ou não: "esta loja vai comprar este produto nos próximos 92 dias?" — e treinar um modelo de machine learning para responder com uma probabilidade.
como montei os exemplos
Volto no tempo mês a mês. Em cada data, para cada par loja × produto ainda não comprado, calculo 43 características (do cliente, do produto e da combinação, como "participação da categoria nas compras da loja") usando só dados anteriores àquela data. O rótulo é 1 se a compra aconteceu nos 92 dias seguintes, 0 caso contrário.
Um cuidado estatístico importante: "não comprou" não quer dizer "não gosta" — talvez a loja nunca tenha visto o produto. Por isso (a) o rótulo vale só para aquela janela, (b) só entram lojas que fizeram algum pedido na janela, ou seja, que tiveram oportunidade de comprar, e (c) saber se a loja já viu, clicou ou rejeitou o produto entra como característica.
Como só ~4% dos pares são compras, uso uma amostra dos "não" e dou a cada um peso inverso à taxa de amostragem — isso mantém as probabilidades corretas.
os modelos
Treino três — regressão logística (linear e interpretável), random forest (média de muitas árvores) e LightGBM (árvores em sequência, cada uma corrigindo os erros da anterior) — e fico com o melhor num período de validação. Depois aplico a calibração de Platt, que ajusta as probabilidades para que "30%" signifique de fato cerca de 30% de compras.
onde brilha e onde falha
É o melhor especialista isolado (NDCG@10 0,289), porque combina todos os sinais e aprende com todas as lojas — inclusive dá palpites razoáveis para lojas novas. O preço é ser mais lento de treinar e menos transparente que os outros.
a intuição
Responder a "quando sugerimos produtos de vestidos para esta loja, ela costuma reagir bem?" — e, principalmente, quanta certeza temos disso. Uma loja que respondeu bem 2 vezes em 2 é muito diferente de uma que respondeu bem 200 vezes em 200.
a distribuição Beta
A taxa de resposta θ é desconhecida, então ela é tratada como uma variável com distribuição Beta(α, β). Dá para pensar em α como "sucessos imaginários" e β como "fracassos imaginários"; a média é α/(α+β) e, quanto maior α+β, mais estreita (mais certa) a distribuição.
A grande vantagem é a atualização conjugada: observou s sucessos e f fracassos? Basta somar.
dois estágios e evidência com pesos
Modelo o funil em dois passos, por loja × categoria: interesse (reagiu positivamente à sugestão?) e conversão (dado o interesse, comprou?). A probabilidade de compra é o produto dos dois. Cada reação conta diferente:
- compra: sucesso nos dois estágios — a evidência mais forte;
- clique ou "gostei": sucesso no interesse, fracasso na conversão;
- rejeição explícita: um fracasso inteiro no interesse;
- ver e ignorar: só 0,25 de fracasso no interesse — talvez a loja nem tenha visto direito. Ignorar não é rejeitar.
de onde vem o ponto de partida (prior)
Antes de qualquer interação, a estimativa de uma loja parte da média das lojas do mesmo segmento (sem contar ela mesma), puxada para a média geral quando o segmento tem poucos dados. A força desse ponto de partida é estimada dos próprios dados (Bayes empírico).
onde brilha e onde falha
Mostra a incerteza de forma honesta (intervalos de credibilidade na interface) e aprende instantaneamente com cada clique. Mas trabalha por categoria, não por produto: diz "vestidos funcionam com esta loja", não "qual vestido". Sozinho é fraco (0,185) — seu papel é dar um sinal complementar.
a intuição
Agrupar lojas parecidas — "especialistas em roupa esportiva", "sensíveis a preço", "sazonais" — não para recomendar diretamente, mas para dar contexto aos outros modelos (o ponto de partida bayesiano e uma das características do supervisionado vêm daqui).
como funciona
Cada loja vira um ponto com ticket médio, frequência, diversidade de categorias, sensibilidade a preço, recência, sazonalidade e participação de cada categoria — todos padronizados para ficar na mesma escala. O K-Means encontra k centros e põe cada loja no grupo do centro mais próximo, minimizando:
quantos grupos?
Testo k de 2 a 10 e escolho pelo produto de dois critérios: silhouette (os grupos estão bem separados?) e estabilidade (se eu reamostrar as lojas e rodar de novo, os grupos se mantêm?). Comparo também com outro algoritmo, o agrupamento hierárquico de Ward. Os nomes dos grupos são gerados automaticamente a partir do que distingue cada centro da média.
onde brilha e onde falha
Dá vocabulário e contexto. Lojas com menos de 3 pedidos não são agrupadas — recebem "sem histórico suficiente" em vez de um rótulo arbitrário.
Como o sistema decide quanto ouvir cada especialista
Esta é a parte que eu mais queria testar. Em vez de pesos fixos iguais para todo mundo, cada loja recebe seus próprios pesos. São cinco passos:
1. Colocar as notas na mesma régua. A nota do conteúdo é um cosseno, a do supervisionado é uma probabilidade, a da popularidade é uma contagem — misturá-las direto seria somar metros com quilos. Então, para cada loja, troco cada nota pela sua posição entre os produtos possíveis, convertida para 0–1 (percentil). Um especialista que dá a mesma nota para tudo vira 0,5 em tudo e não atrapalha a ordem.
2. Medir o que sabemos da loja. Número de pedidos e de produtos distintos, quantas sugestões já viu, quão parecida ela é com outras lojas, quão consistente é o histórico, se mudou de gosto recentemente, há quantos dias não compra.
3. Regras de bom senso. Cada sinal vira uma confiança entre 0 e 1 para cada especialista: poucos pedidos → pouca confiança no colaborativo; histórico consistente → mais conteúdo; muitos vizinhos parecidos → mais colaborativo; muitas interações → mais bayesiano e supervisionado; loja nova → mais popularidade. Os pesos são as confianças divididas pela soma.
4. Um ajuste aprendido por cima das regras. As regras são palpites meus. Então um pequeno modelo aprende correções a elas olhando o que funcionou num período passado:
Aqui \(r_e\) é a confiança dada pela regra, \(b_e\) um ajuste geral por especialista e \(\theta_e\) ajustes que dependem dos sinais \(\phi\) da loja. Se o aprendizado não encontrar nada, \(b = \theta = 0\) e o sistema volta exatamente às regras. O "softmax" garante pesos positivos que somam 100%.
5. Não confiar cegamente no ajuste. Com poucas lojas, um modelo de 60 parâmetros pode decorar ruído. Então comparo, por validação cruzada (treinando com parte das lojas e testando nas outras), três versões — só regras, só o ajuste geral, ajuste completo — e fico com a que vai melhor fora dos dados de treino. Com 50 lojas, venceram as regras; com 300, venceu o ajuste completo.
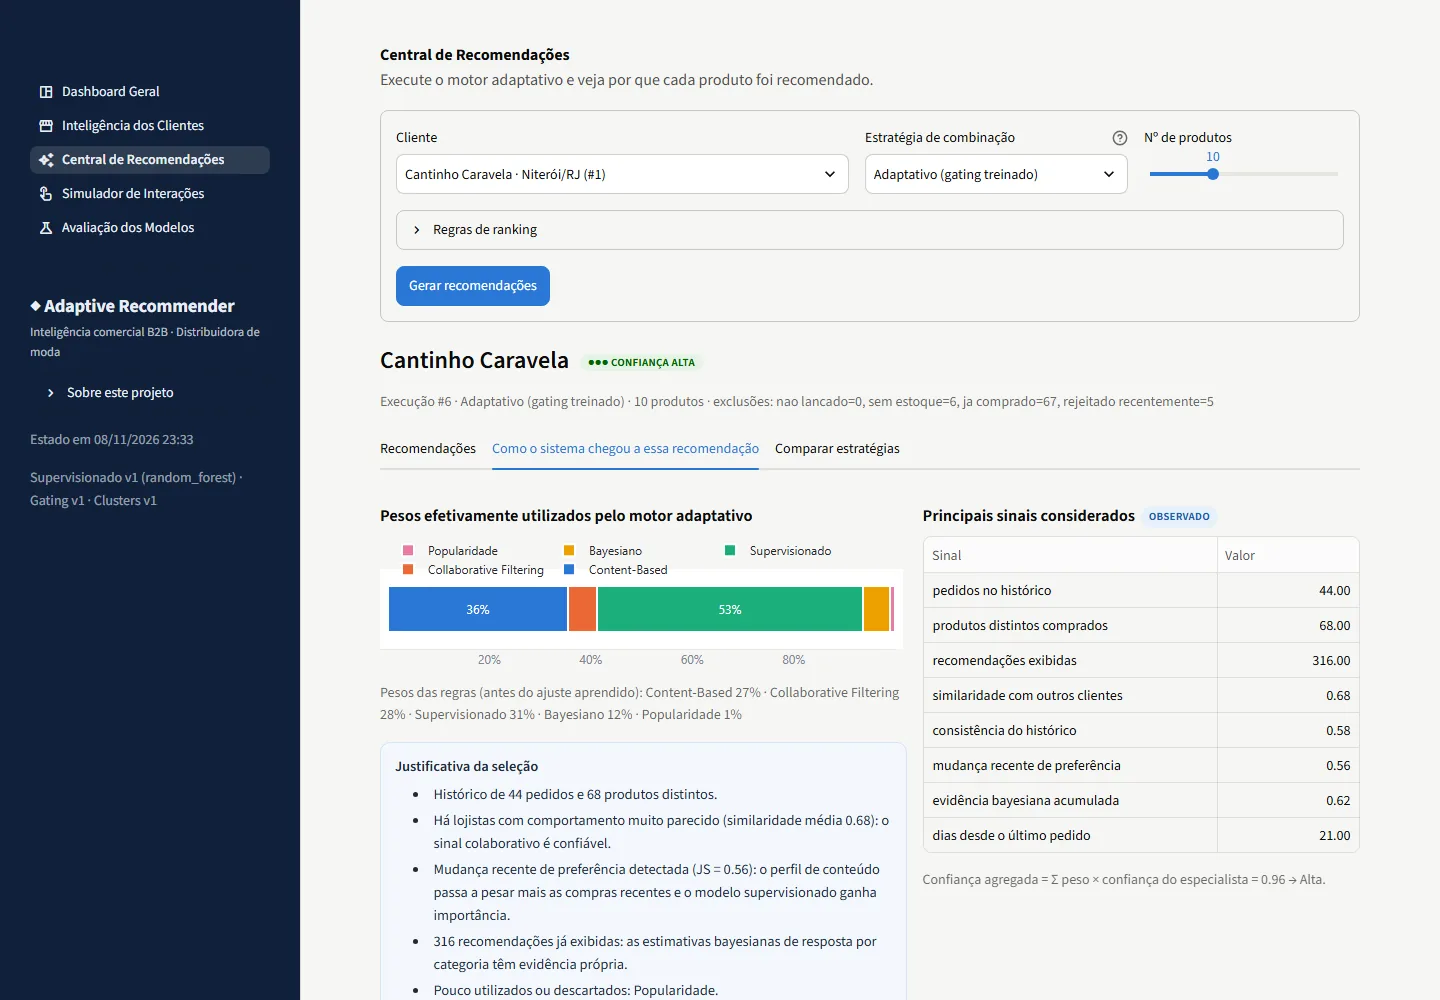
Cada recomendação mostra os pesos usados, a justificativa em português, os especialistas descartados e um nível de confiança (fig. 3).
Da nota à lista — e o que acontece depois de um clique
Filtrar antes de ordenar. Ficam de fora produtos sem estoque, ainda não lançados, já comprados pela loja (há uma opção para permitir recompra depois de N dias) e rejeitados nos últimos 180 dias. Produtos mostrados várias vezes sem resposta perdem 15% da nota ("fadiga"), para a lista não ficar repetitiva.
Diversificar, se quiser. Com a Maximal Marginal Relevance, cada próximo item é escolhido equilibrando relevância e diferença em relação ao que já está na lista:
Com λ = 1 a lista é só relevância; valores menores trazem mais variedade.
Aprender com um clique — um exemplo. Suponha que, para "vestidos", a estimativa bayesiana de interesse de uma loja seja Beta(3, 7): média 3/10 = 30%. A loja vê uma sugestão de vestido e…
- …clica: vira Beta(4, 7), média 4/11 ≈ 36%;
- …ignora: vira Beta(3, 7,25), média ≈ 29% — quase nada muda, porque ignorar é uma evidência fraca;
- …rejeita: vira Beta(3, 8), média 3/11 ≈ 27%.
Se depois do clique a mesma loja compra o vestido, o sistema aplica só a diferença entre "clicou" e "comprou", para não contar a mesma sugestão duas vezes. Com isso, atualizar um evento por vez dá exatamente o mesmo resultado que recalcular tudo do zero — isso está verificado nos testes.
O que muda na hora e o que espera o retreino. Depois de um feedback mudam imediatamente: a estimativa bayesiana, as características da loja, o perfil de conteúdo, a linha da loja na matriz colaborativa e os pesos do motor. Já o modelo supervisionado, a fatoração, os segmentos e o motor treinável só são reajustados numa rotina controlada de retreino, que cria novas versões e nunca apaga dados.
Funcionou? Medindo sem enganar a si mesmo
O protocolo. Treino com dados até abril/2026, uso maio–julho para escolher hiperparâmetros e treinar o motor, e testo em agosto–outubro. No teste, os modelos são reajustados com tudo até 31 de julho, mas o motor usa os pesos aprendidos antes — ninguém vê o período de teste.
As métricas, para a lista dos 10 primeiros de cada loja:
- Precision@10: dos 10 sugeridos, quantos a loja comprou de fato.
- Recall@10: dos produtos novos que a loja comprou, quantos estavam na lista.
- NDCG@10: como o recall, mas premiando acertos no topo — acertar na 1ª posição vale mais que na 10ª. Vai de 0 a 1.
- Cobertura: que fração do catálogo aparece em alguma lista (sugerir sempre os mesmos 20 produtos é sinal ruim).
A incerteza. Com 273 lojas no teste, parte da diferença entre dois métodos é sorte. O bootstrap estima isso: sorteio 2.000 vezes um conjunto de 273 lojas com reposição, recalculo a média e vejo entre que valores ela varia (o intervalo de 95%). Para comparar dois métodos, faço o mesmo com a diferença entre eles loja a loja (bootstrap pareado): se o intervalo da diferença inclui zero, não dá para dizer que um é melhor.
| estratégia | NDCG@10 | IC 95% | recall@10 | precision@10 | cobertura |
|---|---|---|---|---|---|
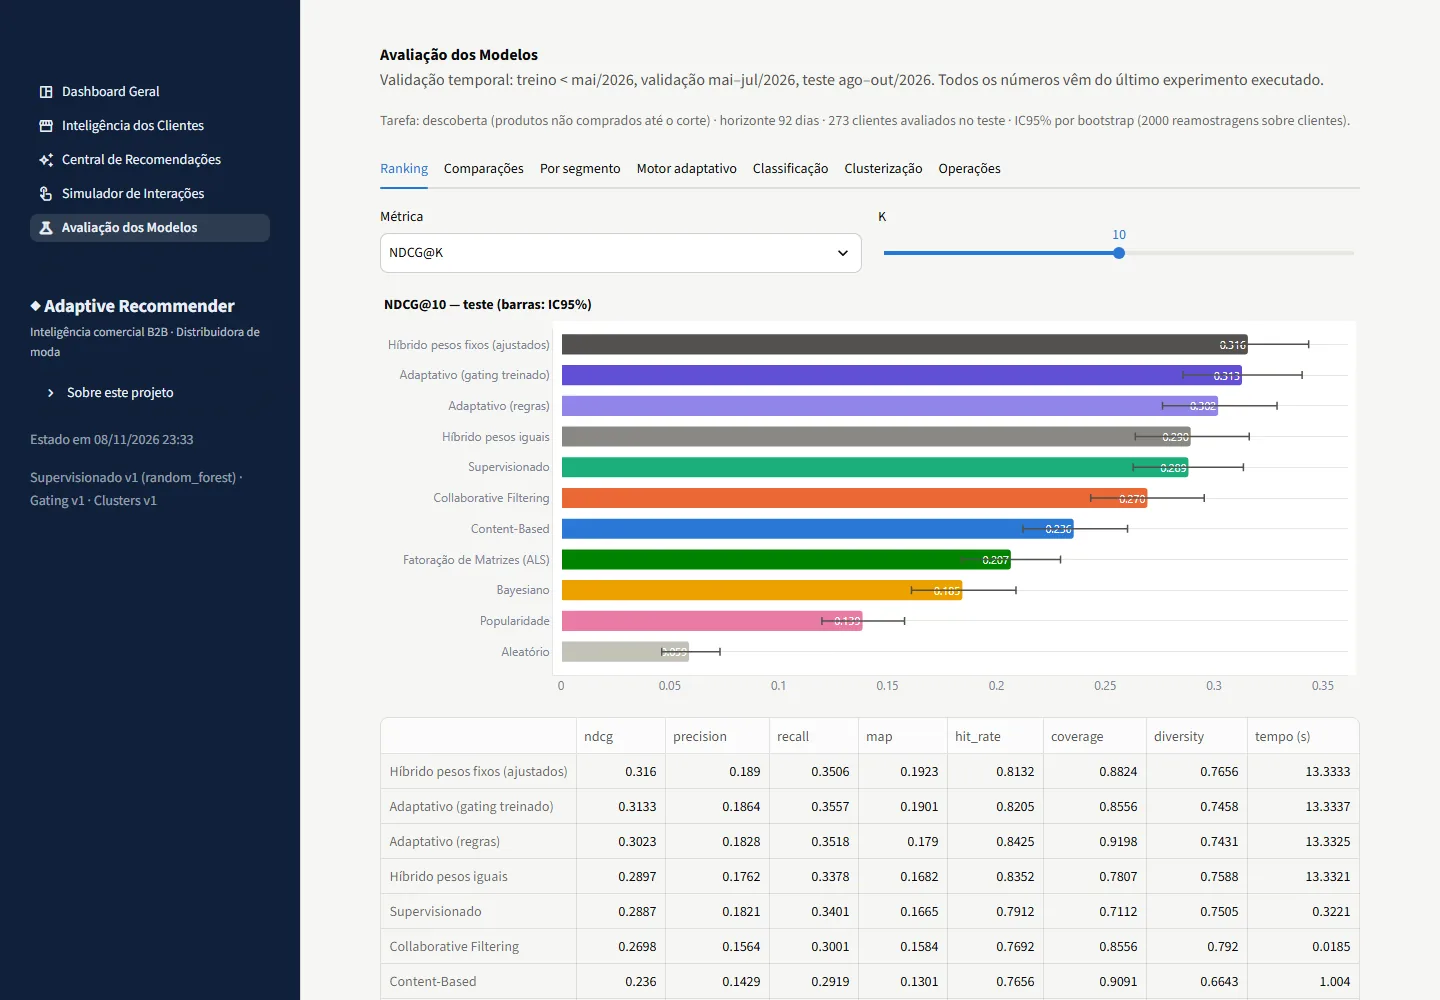
| Híbrido · pesos fixos | 0,316 | [0,287; 0,343] | 0,351 | 0,189 | 0,88 |
| Adaptativo · gating treinado | 0,313 | [0,286; 0,340] | 0,356 | 0,186 | 0,86 |
| Adaptativo · regras | 0,302 | [0,276; 0,329] | 0,352 | 0,183 | 0,92 |
| Híbrido · pesos iguais | 0,290 | [0,264; 0,316] | 0,338 | 0,176 | 0,78 |
| Supervisionado | 0,289 | [0,263; 0,313] | 0,340 | 0,182 | 0,71 |
| Colaborativo (kNN) | 0,270 | [0,243; 0,295] | 0,300 | 0,156 | 0,86 |
| Conteúdo | 0,236 | [0,212; 0,260] | 0,292 | 0,143 | 0,91 |
| Fatoração (ALS) | 0,207 | [0,184; 0,229] | 0,262 | 0,136 | 0,93 |
| Bayesiano | 0,185 | [0,161; 0,209] | 0,202 | 0,105 | 0,98 |
| Popularidade | 0,139 | [0,120; 0,158] | 0,152 | 0,098 | 0,30 |
| Aleatório | 0,059 | [0,046; 0,073] | 0,069 | 0,038 | 1,00 |
As comparações que importam. A coluna "leitura" aplica a regra acima, sem interpretação minha:
| comparação (A − B) | Δ NDCG@10 | IC 95% | leitura |
|---|---|---|---|
| Adaptativo · gating treinado − Híbrido · pesos fixos | −0,003 | [−0,019; +0,014] | empate — o intervalo inclui zero |
| Adaptativo · regras − Híbrido · pesos fixos | −0,014 | [−0,029; +0,003] | empate — o intervalo inclui zero |
| Adaptativo · gating treinado − Adaptativo · regras | +0,011 | [−0,002; +0,023] | empate — o intervalo inclui zero |
| Adaptativo · gating treinado − Supervisionado | +0,025 | [+0,006; +0,043] | A melhor — diferença consistente |
| Adaptativo · regras − Supervisionado | +0,014 | [−0,007; +0,035] | empate — o intervalo inclui zero |
| Híbrido · pesos fixos − Supervisionado | +0,027 | [+0,003; +0,050] | A melhor — diferença consistente |
| Adaptativo · gating treinado − Híbrido · pesos iguais | +0,024 | [+0,011; +0,037] | A melhor — diferença consistente |
| Supervisionado − Popularidade | +0,150 | [+0,123; +0,177] | A melhor — diferença consistente |
| Colaborativo (kNN) − Fatoração (ALS) | +0,063 | [+0,042; +0,085] | A melhor — diferença consistente |
Por quantidade de histórico. Uma das promessas do motor adaptativo era ir melhor para lojas novas. Os dados dizem:
| lojas | n | popularidade | supervisionado | pesos fixos | adaptativo |
|---|---|---|---|---|---|
| histórico extenso | 204 | 0,117 | 0,284 | 0,314 | 0,317 |
| histórico moderado | 35 | 0,163 | 0,284 | 0,297 | 0,286 |
| pouco histórico | 16 | 0,233 | 0,370 | 0,416 | 0,406 |
| sem histórico | 18 | 0,259 | 0,275 | 0,285 | 0,247 |
NDCG@10 no teste por quantidade de histórico da loja no momento da recomendação. Grupos pequenos (n < 20) são indicativos, não conclusivos. Fonte: docs/MODEL_EVALUATION.md.
O que eu concluo. Combinar especialistas ajuda de verdade: os híbridos superam qualquer especialista isolado com folga estatística. Mas o motor adaptativo — a parte mais sofisticada — empata com uma combinação simples de pesos fixos bem escolhidos (Δ = −0,003, intervalo de −0,019 a +0,014), e perde para ela nas lojas sem histórico. Por isso ele não é declarado superior.
A lição de que mais gostei. Comecei com 50 lojas. Ali, o motor treinável não conseguia aprender nada (a validação cruzada sempre escolhia as regras) e aparecia uma vantagem bonita do adaptativo em "lojas que mudaram de gosto" — com 7 lojas nesse grupo. Ao subir para 300 lojas, os intervalos de confiança ficaram mais de duas vezes mais estreitos, o motor passou a aprender… e a vantagem desapareceu. Era ruído. Se eu tivesse parado nas 50 lojas, teria uma conclusão bonita e falsa.
E fora do mundo que eu mesmo inventei?
Dados sintéticos têm um problema de fundo: fui eu quem criou os padrões. Para checar, rodei o mesmo código, sem mudar nenhum modelo, sobre o Online Retail II (UCI Machine Learning Repository): transações reais de 2009 a 2011 de um atacadista online do Reino Unido, cujos clientes são em boa parte revendedores — um cenário B2B parecido.
- Limpeza: de 1.067.371 linhas, removi cancelamentos, devoluções, clientes anônimos e códigos que não são produtos (frete, ajustes, taxas bancárias), ficando 802.632.
- Adaptação: o dataset não tem categorias, então elas são derivadas das descrições por palavras-chave (bolsas, cozinha, velas, Natal…). Usei os 400 produtos com mais compradores antes do período de validação e uma amostra aleatória de 500 clientes — 58 deles só aparecem no período de teste (cold start real).
- O que falta: não há registro de recomendações, então o especialista bayesiano fica sem evidência própria.
| estratégia | NDCG@10 | IC 95% | recall@10 | precision@10 | cobertura |
|---|---|---|---|---|---|
| Híbrido · pesos fixos | 0,094 | [0,076; 0,112] | 0,086 | 0,066 | 0,39 |
| Supervisionado | 0,091 | [0,072; 0,111] | 0,082 | 0,061 | 0,66 |
| Híbrido · pesos iguais | 0,085 | [0,068; 0,104] | 0,087 | 0,067 | 0,30 |
| Colaborativo (kNN) | 0,085 | [0,069; 0,101] | 0,090 | 0,063 | 0,84 |
| Adaptativo · gating treinado | 0,084 | [0,066; 0,102] | 0,088 | 0,065 | 0,38 |
| Fatoração (ALS) | 0,081 | [0,063; 0,100] | 0,080 | 0,059 | 0,95 |
| Adaptativo · regras | 0,080 | [0,062; 0,099] | 0,079 | 0,061 | 0,67 |
| Bayesiano | 0,073 | [0,058; 0,089] | 0,058 | 0,058 | 0,09 |
| Popularidade | 0,070 | [0,055; 0,085] | 0,058 | 0,060 | 0,09 |
| Conteúdo | 0,069 | [0,053; 0,086] | 0,068 | 0,052 | 0,86 |
| Aleatório | 0,034 | [0,025; 0,044] | 0,026 | 0,028 | 1,00 |
Leitura. Todos os números caem — dados reais são muito mais esparsos (a mediana é de 3 pedidos por cliente) —, mas a história se repete: todos os métodos superam o acaso com folga, e as melhores estratégias (pesos fixos 0,094, supervisionado 0,091, colaborativo 0,085, adaptativo 0,084) ficam estatisticamente empatadas. O conteúdo sofre com descrições curtas e o bayesiano, sem interações, vira quase uma popularidade. Nenhuma mágica — e isso, para mim, é uma boa notícia sobre a honestidade da avaliação.
Tudo numa interface que dá para explorar
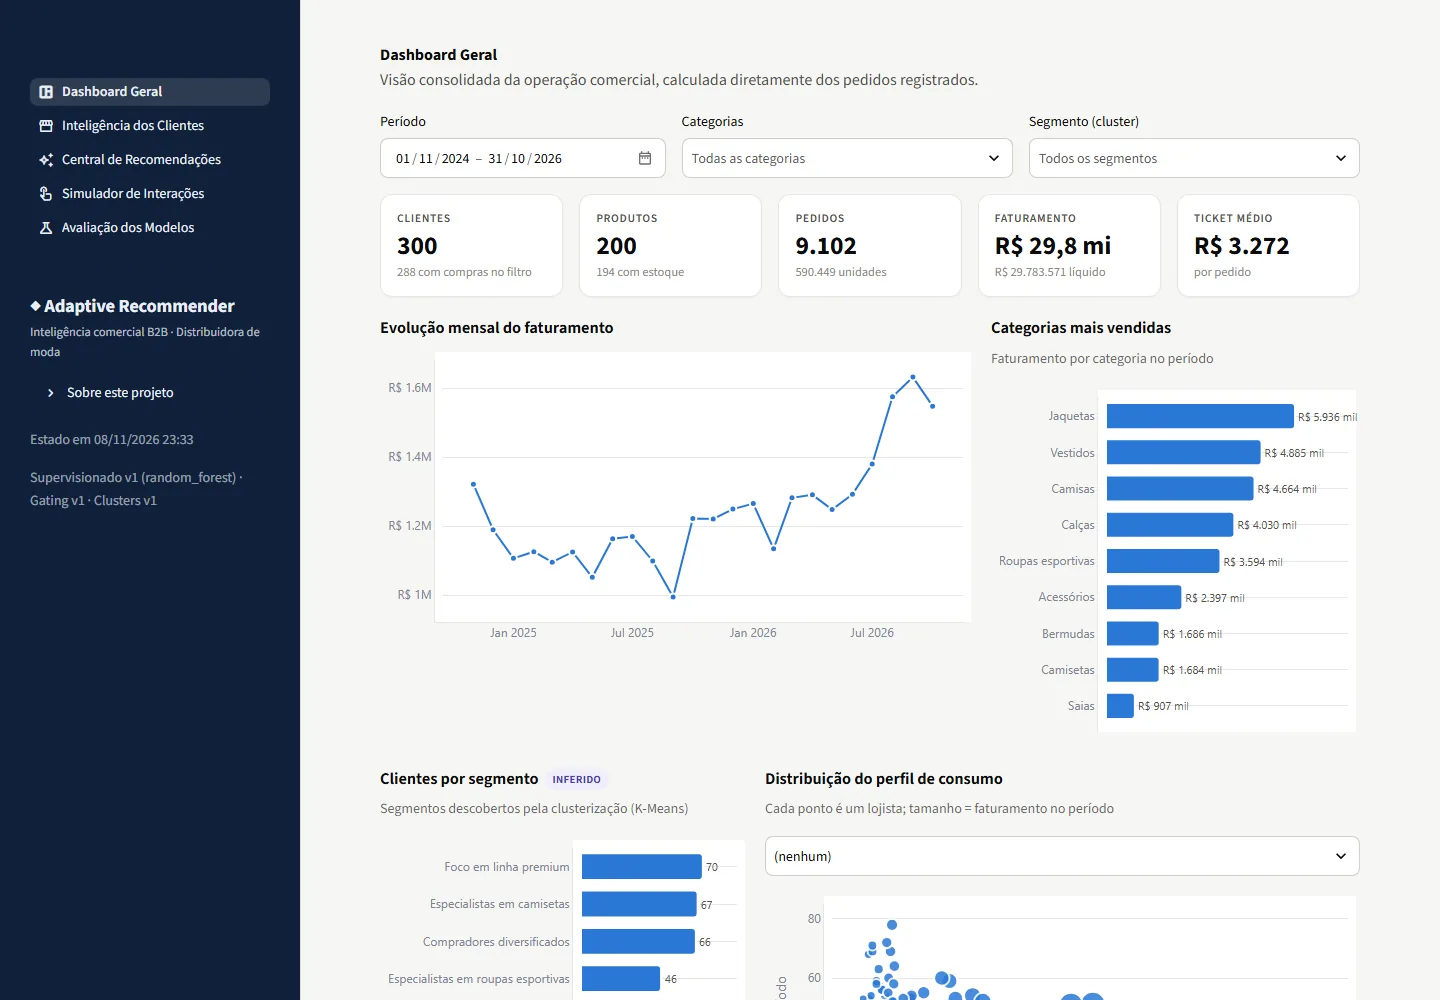
Um app Streamlit com cinco páginas roda tudo localmente: painel de vendas, inteligência de clientes (com dados observados e inferidos marcados de forma diferente), central de recomendações com a explicação dos pesos, simulador de interações (cada clique é gravado e atualiza os modelos de verdade) e um laboratório de avaliação com todos os gráficos acima.
Lições e limites
- A estrutura de avaliação vale mais que o modelo. Separar o tempo, comparar contra linhas de base justas e mostrar a incerteza foi o que me impediu de acreditar numa conclusão falsa.
- Tamanho de amostra decide o que dá para aprender. O mesmo motor treinável não aprendia nada com 50 lojas e aprendia com 300.
- Sofisticação não é garantia. Um motor adaptativo com regras, softmax e validação cruzada empatou com cinco pesos fixos bem escolhidos. Em produção, eu começaria pelos pesos fixos.
- Ignorar não é rejeitar. Tratar ausência de clique como "não gosta" teria distorcido o modelo bayesiano e o supervisionado.
- Limites: os dados principais são sintéticos (o gerador define a "verdade"); alguns modelos são complexos demais para ~300 clientes — de propósito, era um laboratório; os resultados de grupos pequenos (como cold start) são indicativos; o bayesiano só funciona onde existem registros de interação.
Projeto pessoal de fim de semana, feito para aprender. Dados reais: Online Retail II (Chen, D., UCI Machine Learning Repository, CC BY 4.0), baixado em tempo de execução e não redistribuído.